小米 MiMo TTS 批量抽卡:给游戏台词自动配音的一次工程实践
写在前面
给后室题材的项目做播报台词,一共 31 条,风格是”老旧通讯设备里传出的通告”。用小米 MiMo 的语音克隆模型配上参考音频,音色基本一把就对了——问题全出在细节上:
- 感叹号和句号后面没有停顿,几个短句糊成一片;
- 同一条台词,有时候干净利落,有时候一个字一个字往外挤;
- 偶尔直接跑飞,一句话合成出 18 秒。
我一开始的直觉是”后处理修一修”,于是接 ffmpeg 剪静音、轻微提速。结果越修越糟——剪静音把句子之间的停顿也一起剪了,最大停顿从 0.41 秒被压到 0.10 秒,听起来反而更黏。
最后一版换了思路:不做任何音频后处理,改成”抽卡”。抽一次,检测这一张合不合格,不合格就再抽,抽到合格的为止。
项目地址:github.com/msksbr515/mimo-tts-gacha,MIT 许可。
下面按”为什么抽卡 / 接口怎么调 / 停顿怎么插 / 怎么判拖沓 / 工程化怎么收拾”的顺序记录一遍。
一、为什么是”抽卡”
同一句话、同样的参考音频、同样的参数,每次出来的结果都不一样。我测了同一条 Warning! Sanity low.:
| 采样 | 时长 | 静音占比 | 最长停顿 |
|---|---|---|---|
| 第 1 次 | 1.76 s | 26% | 0.21 s |
| 第 2 次 | 2.40 s | 28% | 0.51 s |
| 第 3 次 | 2.56 s | 43% | 0.41 s |
| 跑飞的一次 | 7.68 s | — | — |
最长的一次见过 18.56 秒——五个词的台词。
这说明没有哪个固定参数能让它每次都乖。既然修不好,那就筛选:把”合格”定义成一组可测量的指标,不合格就重新请求。
代价是请求数变多。所以后面所有的设计——并发、限速、检测阈值——本质上都是在控制”重抽的成本”。
二、接口结构
接口是 OpenAI 兼容的,用官方 openai 库直接调就行,不需要额外的 SDK。有一点要特别注意:风格提示和台词分别放在 user 和 assistant 消息里,而不是拼成一段 prompt。
1 | completion = client.chat.completions.create( |
整条流水线长这样:
flowchart LR
    A["台词 txt"] --> B["句末标点后插停顿标记"]
    B --> C["调接口抽一次"]
    C --> D{"拖沓检测"}
    D -->|"达标"| E["落盘 output 时间戳目录"]
    D -->|"不达标"| F{"还有重抽次数"}
    F -->|"有"| C
    F -->|"没有"| G["丢弃并记 FAIL"]
    E --> H["logs 日志与报告"]
    G --> H
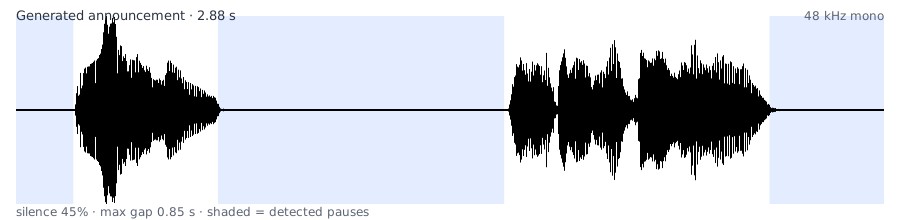
▲ 脚本自己生成的一条音频:蓝色是波形,浅蓝阴影是它识别出的停顿
三、停顿:不要靠标点,靠标记
TTS 对句末标点的停顿很不稳定,尤其参考音频本身节奏偏快时,句号和感叹号听起来是黏在一起的。
按官方文档的音频标签用法,想要停就插一对方括号 []:
1 | Warning! Sanity low. |
听起来简单,但”插在哪”是个坑。第一版我天真地按”所有句号都插”,结果:
| 原文 | 错误结果 | 问题 |
|---|---|---|
This is M.E.G. Base Alpha. |
在 M.E.G. 后面也插了 |
缩写被当成句号 |
J. Smith said hi. |
在 J. 后面插了 |
姓名首字母 |
It costs 3.5 dollars. |
在 3.5 后面插了 |
小数 |
no space.Here |
插了 | 句点后没有空格 |
后来定的判定原则只有一条:ASCII 标点后面必须跟空格,才算真正的句子边界。
| 输入 | 输出 | 原因 |
|---|---|---|
Ready. Go |
Ready.[] Go |
句点后跟空格,句子边界 |
M.E.G. Base |
不插入 | 词内含点,属缩写 |
J. Smith |
不插入 | 单个大写字母,属姓名首字母 |
Mr. Lee、e.g. this |
不插入 | 缩写词表 |
Costs 3.5 units |
不插入 | 句点后是数字 |
no space.Here |
不插入 | 句点后无空格 |
"Stop!" Next |
"Stop!"[] Next |
跳过收尾引号后是空格 |
你好。再见 |
你好。[]再见 |
全角标点不要求空格 |
行尾的 . ! |
不插入 | 避免尾部多余静音 |
还有一个细节:引号包住的句末标点。"Stop!" Next 里的 ! 后面紧跟的是引号,不是空格,如果只看”下一个字符”就会漏掉。所以要先跳过收尾引号(" ' ) ] } )),再看跳过之后是不是空格,标记插在引号外面。
一个大坑:别做音频后处理
这是我走的最大的弯路。为了压掉”词与词之间拖沓”,我接了 ffmpeg 的 silenceremove,把所有超过 0.10 秒的静音剪短。
实测一组对比:
| 阶段 | 时长 | 静音占比 | 最长停顿 |
|---|---|---|---|
| 接口原始输出 | 3.36 s | 31% | 0.41 s |
silenceremove 之后 |
2.45 s | 11% | 0.10 s |
最长停顿从 0.41 秒变成 0.10 秒。看起来”更干脆”,但你辛苦用 [] 插出来的句子停顿,也在这一步被抹平了——这就是”感叹号句号没停顿”的根本原因。
所以最终版把所有后处理都删了:接口返回什么就存什么,质量交给”抽卡”来保证。
四、怎么判断”拖沓”
要筛选就得有指标。我读 PCM 算四个量(10 毫秒一帧、每帧抽 1/5 采样,毫秒级,不依赖任何外部工具):
| 指标 | 含义 | 判为拖沓的阈值 |
|---|---|---|
| 时长 | 总长 | > 词数 × 0.9 + 3 秒 |
| 静音占比 | 静音帧 / 总帧 | > 0.55 |
| 最长静音 | 连续静音的最大值 | > 0.90 秒 |
| 语速 | 词数 / 有效语音时长 | < 90 wpm |
其中三个量可以直接写成式子(下文 N 为词数、D 为总时长、S 为静音总时长、T 为有效语音时长):
四项判据合起来就是”合格”的定义:静音占比不超过 0.55、最长停顿不超过 0.9 秒、语速不低于 90 wpm,且总时长不超过上面那个上限。
阈值不是拍脑袋定的。我先量了 6 条自己觉得正常的样本:
| 指标 | 正常范围 | 取值理由 |
|---|---|---|
| 静音占比 | 17% – 43% | 阈值取 0.55,留足余量 |
| 最长停顿 | 0.21 – 0.54 s | 阈值取 0.90 s,不误杀正常换气 |
| 语速 | 133 – 186 wpm | 阈值取 90 wpm,只抓明显拖沓的 |
有一个坑值得单独说:短句的语速毫无意义。Warning! Overheating. 只有两个词,塞进 1.9 秒的有效语音里,算出来 63 wpm——按 90 的门槛会被判”太慢”,于是每条都要白抽两次。
这就是为什么语速判定加了词数下限:
1 | if words >= quality.min_words and wpm < quality.min_wpm: |
min_words 默认 6,短句只看静音和停顿,不看语速。
五、不合格就丢弃,不要”将就”
早期版本的做法是”重抽几次,留其中最不拖的一版”。听起来稳妥,实际是自欺欺人——最不拖的一版仍然拖,只是没那么明显,最后混在 output/ 里,等到剪辑的时候才发现一堆残次品。
现在的规则很干脆:
- 中途某次合格 → 立即保存,停止重抽;
- 抽满 5 次全不合格 → 丢弃,不生成文件,记一条
FAIL,进程退出码为 1。
因为文件没有落盘,下次运行会自然而然地重新抽它——断点续跑跳过的是”已存在的文件”,不存在的自然会重来。这比额外维护一个”失败队列”简单得多。
日志长这样:
1 | time status line file duration silence max_gap wpm retries note |
六、目录与续跑:时间戳子目录
第一版把所有音频平铺在 output/ 里,跑几轮之后就分不清哪批是哪批了。现在每次运行单独一个目录:
1 | output/ |
这里有个容易踩的坑:换了新目录之后,”跳过已存在”的判断就失效了——新目录永远是空的,于是每次运行都会全量重跑,白白烧额度。
解决办法是启动时扫一遍输出根目录(含所有历史子目录),收集已存在的文件名作为索引:
1 | def collect_existing(root: Path) -> set[str]: |
于是”时间戳分目录”和”断点续跑”可以同时成立。
七、并发与限流:429 是反馈,不是敌人
官方对 TTS 模型的限制是 RPM 100 / TPM 10M,按”账号 + 模型 + 所有 Key 合计”计算;此外还有账号级并发上限,超出直接返回 429。
我一开始直接开 4 路并发,结果第一批就吃掉一串 429,还丢了一条。
现在的做法是自适应:
| 机制 | 做法 |
|---|---|
| 令牌桶 | 按 rpm 控制整体速率,从源头不撞限流 |
| 起步并发 | 从 2 路开始,不冒进 |
| 渐进放大 | 连续成功 5 次,加 1 路,直到 concurrency 上限 |
| 遇 429 | 并发立即减半 + 全局冷却,优先采用响应头 Retry-After |
| 重试范围 | 只重试 408 / 429 / 5xx 和连接类错误,其余 4xx 直接失败 |
concurrency 只是上限,实际并发由反馈决定——你不需要猜账号能吃几路。
八、留痕:日志 + 报告
跑批最烦的是”我记得跑过,但不知道哪天跑的、失败的是哪几条”。所以每次运行留两份东西在 logs/:
| 文件 | 内容 |
|---|---|
run_<时间戳>.log |
TSV 明细,一行一条任务,可直接用 Excel 打开 |
report_<时间戳>.md |
Markdown 报告,给人和给 AI 看都行 |
报告结构:
| 章节 | 内容 |
|---|---|
| 1. 概况 | 开始时间、用时、输入文件、输出目录、模型、停顿配置、风格提示 |
| 2. 统计 | 成功 / 跳过 / 失败条数,触发重抽的条目数,重抽总次数 |
| 3. 成功条目 | 逐行列出行号、文件名、时长、静音、最长停顿、语速、重抽次数 |
| 4. 失败条目 | 行号、文本片段、失败原因 |
| 5. 本次配置 | 当次使用的阈值、并发、限速、超时 |
只记成功与失败,跳过的不记——跳过是正常状态,记进去只会把日志灌满。
九、工程化:从 700 行脚本到 10 个模块
第一版是一个 700 行的 main.py,改到后面自己都不敢动。现在拆成包:
| 模块 | 职责 |
|---|---|
cli.py |
解析命令行、装配、返回退出码 |
config.py |
读 .env 与 config.yaml,校验成不可变配置对象 |
text.py |
读文本、整条目、生成文件名 |
pause.py |
停顿标记判定与插入 |
quality.py |
音频统计与拖沓判定 |
api.py |
接口调用、错误分类、退避 |
ratelimit.py |
令牌桶、自适应并发、硬超时 |
runlog.py |
TSV 日志 |
report.py |
Markdown 报告 |
runner.py |
批处理流程与汇总 |
两个原则:
- 配置全部外置到
config.yaml,脚本里不写任何默认业务参数; - 密钥走
.env,config.yaml里留空,优先级是”环境变量 >.env> 配置文件”。
配置文件长这样:
1 | paths: |
依赖也很干净——只用 openai 和 pyyaml,不锁版本,不列它们的传递依赖:
1 | # requirements.txt |
十、踩过的坑
1. 一次等了一千多秒
某次卡住,日志停了很久才报错。原因是重试叠了两层:SDK 自带的 max_retries=2(每次超时 120 秒)× 我自己的 4 次重试,最坏情况要等十几分钟。
修法两条:
- 关掉 SDK 的自动重试:
OpenAI(..., max_retries=0); - 自己加一层墙钟超时:请求放进子线程,主线程
join(60),到点就放弃:
1 | def call_with_deadline(func, seconds: float): |
超时之后 1 秒就重发——挂起多半是服务端丢了连接,等它没意义。
2. [停顿] 被念了出来
我一开始想当然地用了 [停顿] 这种”看着就像标记”的写法,结果模型老老实实把”停顿”两个字念了出来。
正确的做法是用空方括号 []——文档里的音频标签就是这么用的。
3. Windows 终端中文乱码
在 cmd 里好好的,一放进管道(IDE 输出面板、重定向、Git Bash)就花屏。
根因是 Python 在管道里退回系统区域编码(GBK)。但不能无脑设成 UTF-8——真控制台里 Python 走的是宽字符 API,改编码反而会让 cmd 的提示变乱码。
所以要先判断输出目标:
1 | handle = msvcrt.get_osfhandle(stream.fileno()) |
是真控制台就只放宽错误处理,是管道就固定 UTF-8。
4. 报告里的表格被撑破
Markdown 报告里,台词片段如果自带 |,整张表格就错位了。写报告时要把竖线转义掉(我用的是替换成全角斜线),顺便截断超长文本。
结语
这套东西现在的日常用法就一行:
1 | py main.py 新台词.txt |
跑完看 logs/report_<时间戳>.md,成功的条目直接进游戏,失败的补跑一次。
回头看,最有价值的三个决定都不是写代码,而是想清楚该做什么、不该做什么:
- 不做音频后处理——所有”修一下”的冲动,最后都在破坏停顿;
- 不合格就丢弃——不留残次品,问题留到下一轮解决,而不是藏在目录里;
- 把”抽卡”的代价控制在可接受范围——阈值定得保守一点、重抽次数有限、并发自适应,让它跑得久但不烧钱。
项目:github.com/msksbr515/mimo-tts-gacha(MIT)
欢迎 issue 和 PR,尤其欢迎”你这条阈值设错了”这种反馈——quality 那组参数是按我的样本调的,别人的素材大概率要重新标定。
- 标题: 小米 MiMo TTS 批量抽卡:给游戏台词自动配音的一次工程实践
- 作者: 御坂スバル
- 创建于 : 2026-10-25 13:00:00
- 更新于 : 2026-10-25 15:13:57
- 链接: https://msksbr.com/2026/10/25/mimo-tts-gacha/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。